INSIGHT
Tech Blog
LabQ의 엔지니어들이 현장의 문제를 해결하며 얻은 기술적 경험과 R&D 인사이트를 공유합니다.
[INFRASTRUCTURE] FPGA 기반 LLM 추론 솔루션
-
황
황지은
전임연구원
- 26.07.02
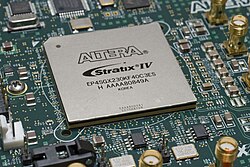
우리가 흔히 아는 스마트폰의 두뇌(AP)나 컴퓨터의 CPU는 공장에서 한 번 만들어지면 그 기능(회로)을 절대 바꿀 수 없습니다. 이를 ASIC(주문형 반도체)이라고 합니다. 건축으로 치면 이미 단단하게 지어진 콘크리트 건물과 같습니다. 하지만 FPGA(Field Programmable Gate Array)는 '현장(Field)에서 프로그래밍(Programmable)이 가능한 반도체 배열'로서, 사용자가 원하는 대로 벽을 세우고 허물 수 있는 '레고 블록'이나 언제든 쓰고 지울 수 있는 '전자 화이트보드' 같은 반도체입니다.
FPGA 내부에는 수많은 논리 블록(Logic Block)과 이들을 연결할 수 있는 전선(Interconnect)들이 깔려 있습니다. 이를 이용해 C언어나 Python 같은 소프트웨어 코딩이 아니라, VHDL이나 Verilog 같은 하드웨어 기술 언어(HDL)를 사용해 반도체 내부의 길(회로)을 직접 설계합니다. 코드를 수정해서 다시 다운로드하면, 반도체 내부 회로가 그 즉시 물리적으로 재배치됩니다.
FPGA의 특징들 중 하나는 각 작업에 칩의 전용 구역을 통째로 할당해 진짜 병렬로 처리한다는 점입니다. 이는 GPU가 수천 개의 코어가 같은 자원을 나눠 쓴다는 점과 대비됩니다. 또다른 특징으로는 불필요한 범용 회로 없이 필요한 연산만 직접 회로로 구현할 수 있어 전력 대비 효율이 좋다는 것입니다.
FPGA는 다음의 분야에서 많이 사용됩니다.
● 반도체 시제품(Prototype) 테스트: 진짜 ASIC 반도체를 만들기 전에, 설계한 회로가 잘 작동하는지 테스트하는 '시험대'로 쓰입니다.
● 통신 및 방산 분야: 5G/6G 통신 기지국이나 레이더 시스템처럼 기술 표준이 계속 바뀌고 신뢰성이 중요한 분야에 쓰입니다.
● AI 및 데이터 센터: 딥러닝 연산 속도를 높이기 위해 서버의 가속기로 탑재되기도 합니다. (최근 빅테크 기업들이 많이 활용하는 추세입니다.)
AI 가속기로서의 FPGA
FPGA를 AI 가속에 쓰는 흐름은 새롭지 않습니다. 대표적으로 마이크로소프트는 Project Catapult와 Project Brainwave를 통해 데이터센터 서버에 FPGA를 대규모로 심었고, 이를 Bing 검색과 Azure의 실시간 AI 추론에 활용했습니다. 네트워크 경로 위에 FPGA를 "선 위의 혹(bump in the wire)"처럼 배치해, 배치 크기 1에서도 낮은 지연으로 신경망을 돌리는 구조로 설계하여 거의 100만 개에 달하는 FPGA를 실제 운영에 투입하했습니다.
여러 다른 가속기들 중 왜 FPGA였을까요? 전력 대비 성능과 일정한 지연시간 때문입니다. 한 연구는 LLM 추론에서 FPGA가 45~225W 수준의 전력으로 동작하며, 에너지 효율이 GPU·CPU보다 훨씬 높다고 보고합니다(최대 약 4.97 tokens/J). 또한 GPU가 자원을 공유하느라 응답 시간이 들쭉날쭉한 데 반해, FPGA는 전용 회로로 예측 가능한(deterministic) 지연시간을 보장합니다. 정해진 시간 안에 반드시 응답해야 하는 실시간 서비스에 적합한 특성입니다.
FPGA의 특장점
FPGA의 장점에 대해 조금 더 자세히 알아보겠습니다. 아래의 그래프는 단일 Rerank 작업을 수행했을 때의 전력 소비량, 소요 시간, 비용을 측정한 것을 여러 하드웨어에 대해 비교한 것입니다.

● 전력 효율: FPGA의 TDP(Thermal Design Power; 칩을 냉각하기 위해 냉각 장치가 처리할 수 있어야 하는 최대 열량으로, 전력 소비의 상한선을 의미)는 약 150W로, GPU 대비 (약 575W) 전력을 훨씬 적게 소모합니다. Rerank 작업 수행에서는 처리 시간이 매우 짧아, 쿼리당 전력 소비로 보면 GPU 대비 약 88% 절감됩니다.
● 속도: 같은 작업을 GPU 대비 약 2배 빠르게 처리합니다.
● 비용(전기요금): 100만 쿼리 기준 전기요금이 GPU는 약 2,287원인데 FPGA는 약 336원 수준으로 떨어집니다.
● 확장성: FPGA는 내부 회로를 모델에 맞게 재구성할 수 있어, 같은 전력·면적에서 처리량을 끌어올릴 수 있습니다. 아키텍처가 고정된 GPU·CPU와 비교해 확장성이 크다고 할 수 있습니다.
그렇다면 이러한 장점들을 바탕으로 LLM 추론 파이프라인에서 FPGA는 구체적으로 어떤 일을 할 수 있을까요? 이 포스팅에서는 크게 두 가지 역할을 살펴보겠습니다.
FPGA의 활용 ① — Reranker
요즘 LLM 서비스는 대부분 RAG(검색 증강 생성) 구조입니다. 질문이 들어오면 먼저 관련 문서를 찾아오고, 그 문서를 근거로 LLM이 답을 만듭니다. 이때 검색은 보통 2단계로 이뤄집니다.
● 1단계(빠른 검색): 질문과 문서를 각각 벡터로 바꿔, 벡터 DB에서 질문과 유사도가 높게 계산되는 문서 후보를 수십 개 빠르게 가져옵니다.
● 2단계(느리지만 정밀한 Reranker): 후보 하나하나를 질문과 한 쌍으로 묶어 모델에 넣고 "이 문서가 정말 질문에 맞나?"를 정밀하게 채점합니다. 이렇게 질문-문서를 함께 보는 모델을 교차 인코더(cross-encoder)라 부르며, 1단계보다 훨씬 정확합니다.
문제는 Reranker로 cross-encoder를 이용할 경우 연산량이 크게 증가한다는 것입니다. 질문과 문서를 하나의 문장처럼 이어 붙여서 모델의 입력으로 넣고, self-attention이 질문의 모든 토큰과 문서의 모든 토큰 사이에서 전부 발생하기 때문에 복잡도가
O(N^2)
이 됩니다. 이 때문에 빠른 1차 검색으로 후보를 좁힌 뒤, 정밀한 Reranker는 그 후보에만 적용합니다. 그리고 이 "정밀 채점"은 같은 연산을 후보마다 반복하는 작업이라, 전용 회로로 병렬화하기 좋은 일입니다. FPGA가 Reranker 가속에 잘 맞는 이유입니다.
FPGA의 활용 ② — Memory tiering
FPGA는 KV cache 메모리 폭증 문제를 토큰의 중요도를 바탕으로 계층(tier)을 나눠 저장함으로써 해결할 수 있습니다.
Memory tiering에 대해 다루기 전에, KV cache 메모리 폭증 문제에 대해 짚고 넘어가겠습니다.
기존 LLM 추론의 문제점
LLM이 답변을 생성할 때 한 번에 모든 문장을 뚝딱 만드는 것이 아닙니다. 단어(토큰)를 하나씩 붙여가며 다음 단어를 예측하는 방식(→ autoregressive(자기 회귀))을 이용합니다.
예시와 함께 LLM이 어떻게 문장을 만드는지 이해해 봅시다.
"나는 학교에..." 뒤에 올 단어를 예측한다고 가정해 봅시다. LLM의 핵심 알고리즘인 Transformer의 Attention 메커니즘은 새로운 단어를 예측할 때마다 앞에 나왔던 모든 단어와의 연관성을 매번 다시 계산해야 합니다.
● 1번째 단어 생성: "나는" → 모델이 전체 연산 후 "학교에" 예측
●. 2번째 단어 생성: "나는 학교에" → 모델이 "나는"과 "학교에"를 처음부터 다시 연산 후 "가서" 예측
●. 3번째 단어 생성: "나는 학교에 가서" → "나는", "학교에", "가서"를 또 처음부터 다시 연산 후 "공부를" 예측
보시다시피 뒤로 갈수록 앞에 단어들이 누적되는데, 이 이전 단어들의 연산(Query, Key, Value 행렬 계산)을 단어가 추가될 때마다 매번 처음부터 똑같이 반복하게 됩니다. 문장이 길어질수록 계산량이 기하급수적으로 늘어나는 비효율이 발생합니다.
KV cache는 무엇이고 왜 필요한가
여기서 Key(K)와 Value(V)는 어텐션 연산에 사용되는 핵심 벡터 데이터입니다.
이미 계산한 과거 토큰들의 Key와 Value 값은 문맥이 바뀌지 않는 한 변하지 않습니다. 그렇다면 "이 변하지 않는 값들을 메모리에 저장(캐싱)해 두고 재사용하면 어떨까?" 하는 아이디어에서 나온 것이 KV 캐시입니다.
KV 캐시가 있을 때에는 아래와 같이 보다 효율적으로 토큰을 생성할 수 있습니다.
● 1번째 단어 생성: "나는"을 연산하고, 이때 나온 "나는"의 K, V 값을 메모리(KV 캐시)에 저장합니다. → "학교에" 예측
● 2번째 단어 생성: "학교에"라는 신규 토큰이 들어옵니다. "나는"은 이미 캐시에 있으므로 연산하지 않고, "학교에"에 대한 K, V 값만 새로 계산해서 캐시에 추가합니다. → "가서" 예측
●. 3번째 단어 생성: 기존 캐시("나는", "학교에")를 그대로 쓰고, "가서"에 대한 K, V만 새로 계산합니다. → "공부를" 예측
KV cache를 사용했을 때와 사용하지 않았을 때의 특징을 정리하면 아래 표와 같습니다.
| 특징 | KV Cache 미사용 | KV Cache 사용 |
| 시간 복잡도 (토큰당) | O(N) (문장이 길수록 느려짐) | O(1) (문장 길이에 상관없이 일정함) |
| 연산 효율성 | 매 토큰마다 과거 연산 전체 반복 (지연시간 폭증) | 신규 토큰만 연산 (첫 단어 이후 답변 속도가 매우 빨라짐) |
결과적으로 KV 캐시를 사용하면 LLM이 답변을 출력하는 속도(Time Per Output Token)가 획기적으로 빨라집니다. 우리가 ChatGPT나 클로드(Claude)를 쓸 때 첫 글자가 뜨고 나서 다음 글자들이 실시간으로 빠르게 찍히는 이유가 바로 이 KV 캐시 덕분입니다.
KV cache 메모리 폭증
KV 캐시가 연산량을 O(N^2)에서 O(N) 수준으로 극적으로 줄여주지만, 치명적인 대가가 따릅니다. 바로 엄청난 GPU 메모리(VRAM) 소비입니다. 문맥(Context)의 길이가 길어질수록, 사용자(Batch Size)가 많아질수록, 모델의 크기(Layer 수, Attention Head 수 등)가 클수록, 메모리에 쌓아두어야 할 KV 캐시의 크기가 기하급수적으로 커집니다. 모델 자체를 GPU에 올리는 비용 외에도 이 KV 캐시 때문에 메모리가 모자라 변환 속도가 느려지거나 서버가 터지는 '메모리 병목 현상'이 발생합니다.
KV 캐시가 쌓이게 되면 토큰을 생성할 때 메모리에서 KV 캐시를 읽어오는 과정에서 메모리 대역폭에 발목이 잡히게 됩니다. 이를 '메모리 벽(Memory Wall)'이라고 부릅니다. FLOPS(연산 성능)를 아무리 늘려도, 데이터를 충분히 빠르게 실어 나르지 못하면 LLM 답변 시간을 단축할 수 없는 것입니다. GPU를 추가로 구매하는 것만으로는 깔끔하게 해결되지 않습니다. GPU는 가격이 비싸고 전력 소모가 크며, 메모리 한계는 여전히 발생하기 때문입니다.
메모리 절감 기술 동향
이와 관련하여 LLM 추론에서 메모리를 효율적으로 관리하기 위한 연구 결과들이 많이 발표되고 있습니다. 아래는 관련 연구 동향을 간단히 정리한 것입니다.
| 기술 | 핵심 아이디어 | 효과 (논문 보고) |
| HillInfer (2026) | GPU → CPU → FPGA SSD 3계층으로 KV를 계층 관리하고, 스토리지(SmartSSD 내장 FPGA)에서 중요도를 평가 | PCIe 우회 near-data 처리로 메모리 제약 환경에서 긴 컨텍스트 처리 |
| Quest (ICML 2024) | KV 페이지의 key 최소/최댓값만 메타데이터로 보관해, 질문 벡터와 비교해 중요한 페이지만 골라 로딩 | self-attention 연산 대비 최대 약 7배 가속 |
| InfiniGen (OSDI 2024) | 다음 레이어에 필요한 KV를 미리 예측해 필수 KV만 prefetch | 오프로딩 시스템 대비 최대 3배 성능 향상 |
세 기술을 한 줄로 요약하면 — HillInfer(계층 관리) + Quest(중요한 것 선택) + InfiniGen(미리 가져오기) 의 조합으로, 같은 인프라에서 KV Cache 병목을 함께 공략하는 것입니다.
Memory tiering
위의 메모리 절감 기술 연구들 중 Hillinfer가 memory tiering에 대해 다루고 있습니다. 앞서 언급한 것처럼, KV cache에 저장된 토큰들에 대해 중요도를 계산하여 계층별로 다른 공간에 나누어 저장하는 것이 memory tiering입니다.
LLM이 답변을 생성할 때, 모든 KV가 똑같이 중요하지는 않습니다. Attention은 다음 토큰을 만들 때 모든 KV에 가중치를 매겨 섞는데, 가중치가 0.05도 안 되는 토큰은 결과에 거의 영향을 주지 않습니다.
그래서 중요도에 따라 KV를 2개 계층에 자동으로 나눠 담습니다.

● Tier 1 (GPU HBM): 지금 당장 쓰는 가장 중요한 KV. 가장 빠르지만 가장 비싸고 좁은 공간.
● Tier 2 (FPGA NAND SSD): 오래 참조되지 않는 '냉각된' KV. 느리지만 수 TB로 넉넉.
여기서 FPGA의 진가가 드러납니다. 어떤 KV가 중요한지 평가하는 일을 FPGA가 직접 맡습니다. FPGA가 저장소 레벨에서 바로(near-data) 중요도를 평가하여 중요도가 높은 토큰들을 GPU로 보냅니다.
반면에 GPU에 로드되어 있던 토큰들 중 중요도가 떨어진 토큰들은 FPGA NAND SSD로 강등됩니다. 이렇게 계층을 나누어 토큰을 관리하면 문맥을 보존하여 정확한 답변을 생성하면서도 메모리 사용 효율을 극대화할 수 있습니다.
FPGA 활용 시 유의할 점
위에서 살펴본 것처럼 FPGA는 LLM 추론에서의 지연 시간 단축과 메모리 병목을 완화하는 훌륭한 솔루션을 제공하지만, 활용할 때 유의할 점들이 있습니다.
● 개발 난이도가 높다. FPGA는 Verilog·VHDL 같은 하드웨어 기술 언어로 회로를 직접 설계해야 하고, 디지털 회로에 대한 이해가 필요합니다. 소프트웨어보다 개발에 시간이 들고, 컴파일(합성) 과정에서도 시간이 소요됩니다. 또한 GPU의 CUDA 생태계처럼 관련 도구·라이브러리가 아직 부족합니다.
●. 클럭이 낮다. 재구성을 위한 배선 오버헤드 때문에 동작 주파수가 보통 수십~수백 MHz로, GHz급인 CPU·GPU나 ASIC보다 낮습니다. 그래서 순수 행렬곱 같은 대규모 연산은 여전히 GPU가 유리할 수 있습니다.
●. 적용 환경 제약. FPGA 기반 메모리 병목 완화 솔루션을 적용하기 위해서는 모델 내부(Attention 레이어, KV Cache)에 직접 개입해야 하므로, OpenAI·Claude 같은 상용 API에는 적용할 수 없고 Llama·Mistral 같은 오픈소스 모델을 온프레미스로 배포한 환경에서만 가능합니다.
정리
LLM 추론의 진짜 병목은 흔히 연산이 아니라 메모리입니다. KV Cache가 끝없이 커지며 GPU 메모리 벽에 부딪히고, 더 비싼 GPU를 사는 것만으로는 이 벽이 사라지지 않습니다. FPGA는 "소프트웨어처럼 다시 그릴 수 있는 하드웨어"라는 성질 덕분에 이 문제에 두 갈래로 기여합니다.
1. Reranker 가속 — 반복적인 정밀 채점을 전용 회로로 병렬화해, 낮은 전력으로 빠르게.
2. Memory tiering — KV의 중요도를 데이터 근처에서 직접 평가해 서로 다른 하드웨어 계층으로 자동 분산, 같은 인프라로 더 긴 컨텍스트를.
더하여, 전력 대비 효율, 예측 가능한 지연, 확장성이라는 FPGA의 강점은, 메모리 벽에 부딪힌 LLM 서비스에 꼭 필요한 솔루션으로 자리매김하고 있습니다.
- 이전글expand_less
- 다음글expand_more